


はじめに
こんにちは、R&D ユニットの葉山です。
今回は近年発展しつつある 3D MLLM(3D Multi-modal Large Language Model) の分野に関連して、点群を解釈できる 3 つの MLLM モデルをご紹介しつつ、ローカル環境*1 で実際に動かした結果をご紹介します。
3D MLLM とは何か
3D MLLM とは簡潔に言えば、点群やボクセルなどの 3D データを含めて解釈が可能なマルチモーダル LLM になります。
一般的な流れとしては、扱いたい 3D データ(ここでは点群)をエンコーダで符号化し、LLM のトークン空間に何らかの方法で埋め込むことで LLM 上で 3D データが扱えるようにします。
点群データを扱う上での難点としては、例えば大規模な「点群 - テキスト」のペアデータが存在しない点が挙げられます。画像なら Web 上に数十億枚の画像とキャプションの組がありますが、点群にはそれがありません。
このように 3D データを扱うことで難易度は上がる面はありますが、近年様々な手法が提案されており発展が進んでいる分野といえます。
PointLLM
手法の概要
まずは後から紹介する 2 手法の前段として、PointLLM(ECCV 2024)についてご紹介します。
この手法では点群を PointBERT *2で符号化し、さらに 3 層の MLP によって LLM のトークン空間へ投影します。学習は2段階で、Stage-1 では LLM を凍結して MLP 部分だけを学習し、Stage-2 で全体をチューニングします。
学習データは Objaverse の 660K オブジェクトです。各オブジェクトは 8192 点の点群として与えられ、XYZ と RGB を持ちます。
M4 Pro で動かす
PointLLM の公式実装を利用して動かしていきます。
実行には公開されている重みデータ RunsenXu/PointLLM_7B_v1.2 を使いました。fp32 なのでダウンロードサイズは 27.65GB ですが、fp16 にキャストすれば 14GB 程度となります。
PointLLM_chat.py をベースに、ローカルの MPS 環境で動くように少し手を加えたスクリプトを用意しました。
実行時間の計測などで少し手を加えて動かしましたが、最小限には .cuda() を .to("mps") に置き換えるだけで良さそうです。
入力する点群は (8192, 6) の float32 配列で、XYZ は単位球に正規化、RGB は [0, 1] に収めます。今回は Poly Haven の CC0 なモデルデータを以下のスクリプトで点群に変換して使いました。
import numpy as np
import trimesh

mesh = trimesh.load("garden_gnome_1k.gltf", force="mesh")
mesh.visual = mesh.visual.to_color()  # テクスチャ参照のままだと色を拾えない
points, _, colors = trimesh.sample.sample_surface(mesh, 8192, sample_color=True)

xyz = points - points.mean(axis=0)
xyz /= np.linalg.norm(xyz, axis=1).max()
rgb = colors[:, :3].astype(np.float32) / 255.0

np.save("garden_gnome_8192.npy", np.concatenate([xyz, rgb], axis=1).astype(np.float32))
試した結果
実験1:庭のノーム像(Poly Haven garden_gnome)
赤い帽子・白いひげ・緑の服・青いズボンという多色の物体で、形状と色に対する解釈の性能を見る題材として選びました。
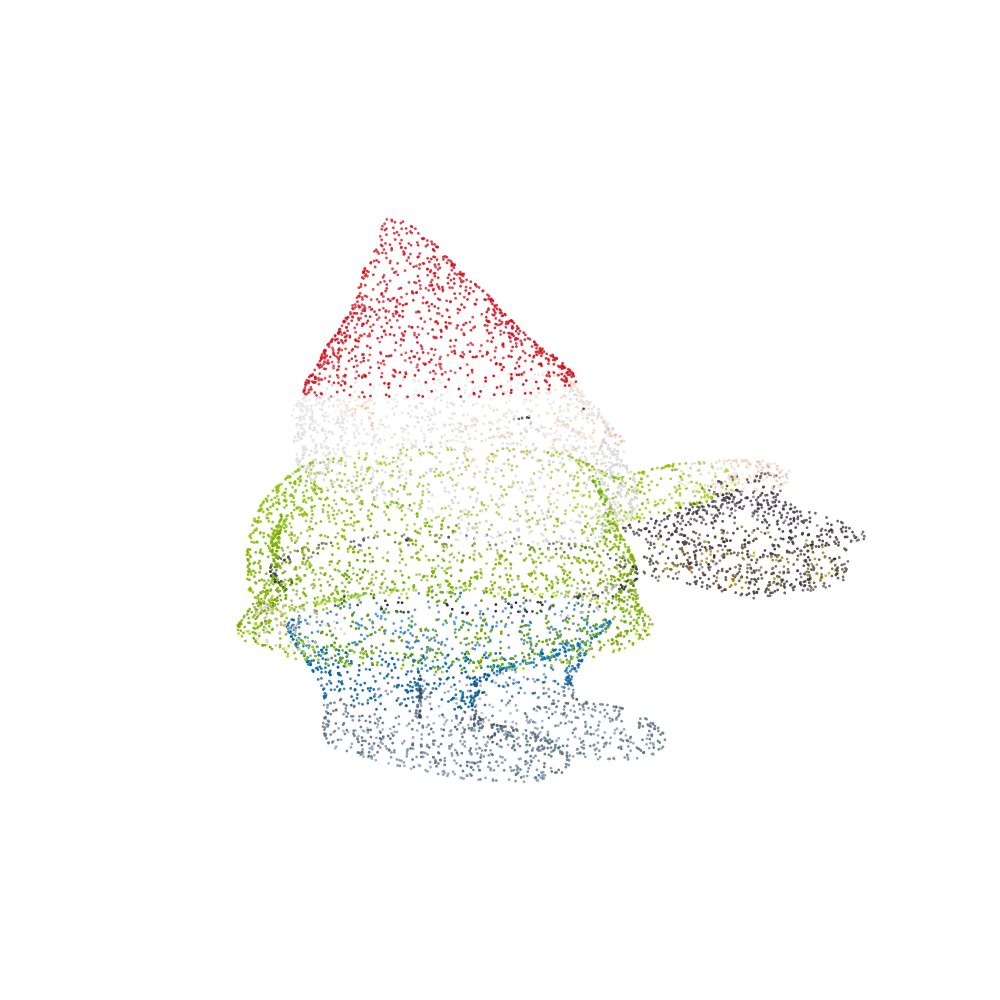
(PointLLM を含め、今回紹介する手法では日本語でのプロンプトには基本的には対応していないので英語プロンプトで実験を行っています)
| プロンプト | 応答 |
|---|---|
| What is this? | cartoon-style small doll, dressed in green clothes and red shoes |
| What color is this object? | predominantly green |
| Caption this 3D model in 1 sentence. | cartoon-style small red devil with a mischievous grin |
「緑の服・赤い靴の人形」までは理解できていますが、「庭のノーム像」とまでは判断できていませんでした。また、プロンプトを変えると doll から red devil へ解釈が揺れていました。
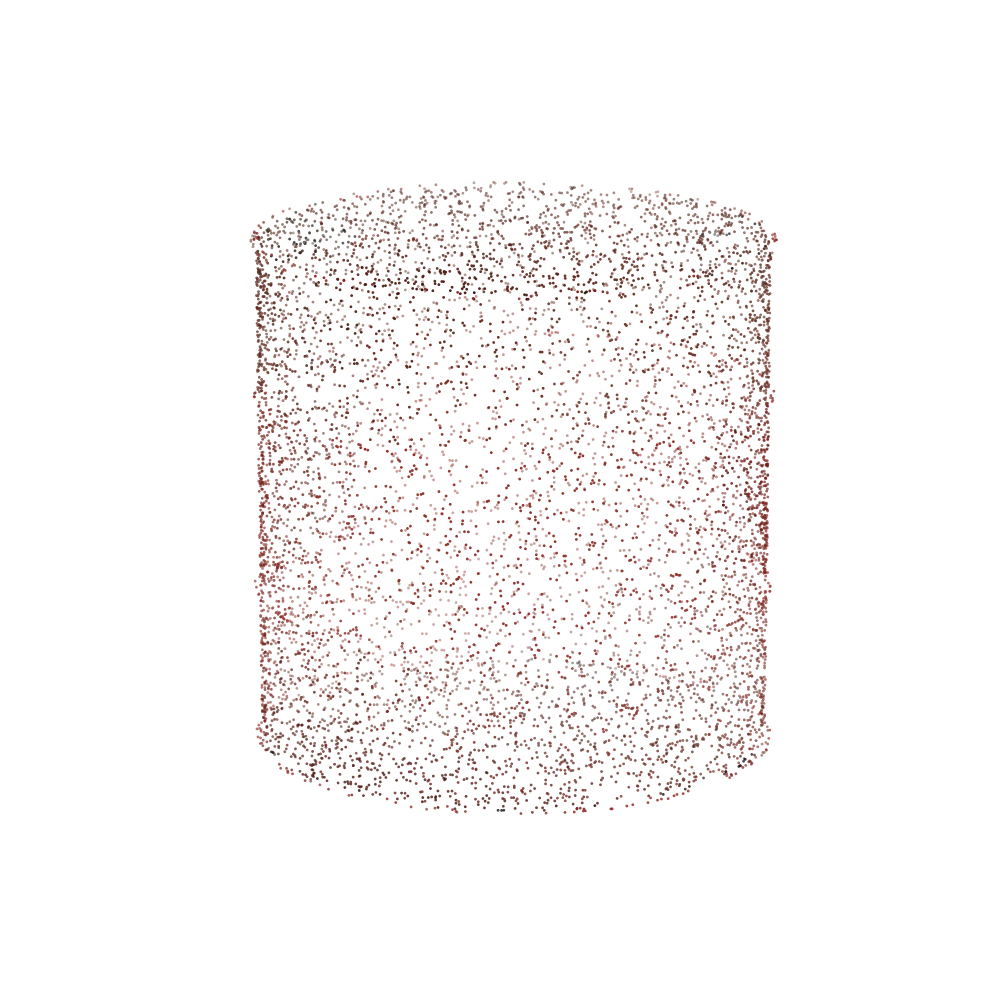
実験2:赤い樽 vs 青い樽
形状がほぼ同一で色だけが違う2つのモデルを比較します。
| Barrel_01(赤) | barrel_03(青) |
|---|---|
 |
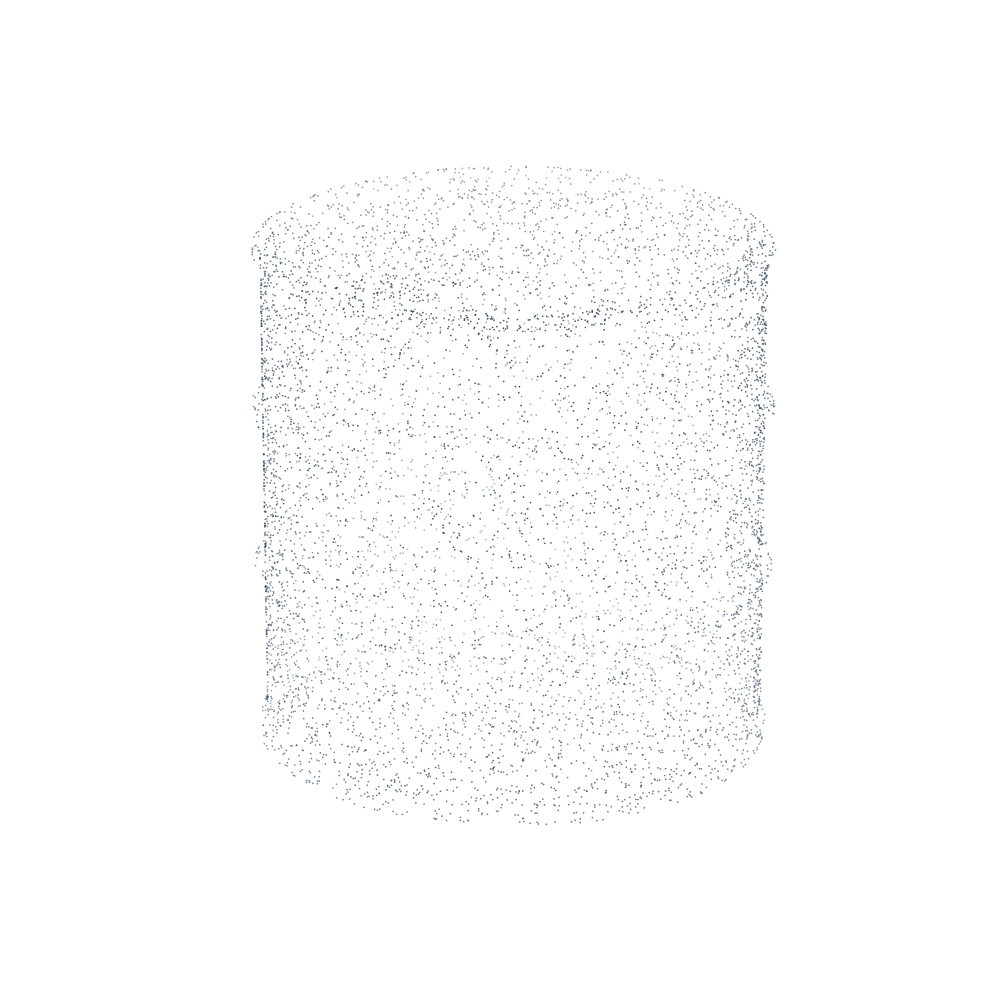 |
以下のように色について着目して質問を投げてみました。
| Barrel_01(赤) | barrel_03(青) | |
|---|---|---|
| What is this? | cartoon-style red barrel | cartoon-style oil tank, vibrant blue |
| What color is this object? | The object is red. | a vibrant shade of blue. |
色を変えただけで、物体名の解釈まで barrel から oil tank に変わりました。 色情報がきちんと応答に反映されていることが確認できます。
速度は M4 Pro でモデルロードが 8〜20秒、1応答あたり 11〜44秒でした。対話的に使うには少し待たされますが、十分実行可能な範囲でした。
GreenPLM
手法の概要
GreenPLM(AAAI 2025)の発想は、一言で言えば 「3D データが足りないなら、その分をテキストで埋める」 です。
点群と LLM の間には必ずテキストの空間が挟まるため、その中間のテキスト空間の学習を入念に行っておけば、数少ない「点群 - テキスト」の学習データに頼る割合を減らせるはずだ、という発想です。
学習は3段階で、最初の2段階はテキストのみでテキスト部分の基礎を作り、3段階目で初めて少量の 3D データを足します。この方針で 3D データを 12% しか使わずに従来手法を上回る という結果を報告しています。
M4 Pro で動かす
こちらも公式実装を使って動かしていきますが、手元の M4 Pro 環境で動かすために以下の点を変更しています。
まず一つ目は point_encoder.py で点群エンコーダに Uni3D を使っている関係で、CUDA 専用拡張の import があります。
from pointnet2_ops import pointnet2_utils

def fps(data, number):
    fps_idx = pointnet2_utils.furthest_point_sample(data, number)
    ...
こちらの pointnet2_ops の利用をやめて、最遠点サンプリングを PyTorch で以下のように書き直して動かしました。
def fps(data, number):
    B, N, C = data.shape
    centroids = torch.zeros(B, number, dtype=torch.long, device=data.device)
    distance = torch.full((B, N), 1e10, device=data.device, dtype=data.dtype)
    farthest = torch.zeros(B, dtype=torch.long, device=data.device)
    batch_indices = torch.arange(B, dtype=torch.long, device=data.device)

    for i in range(number):
        centroids[:, i] = farthest
        centroid = data[batch_indices, farthest, :].view(B, 1, C)
        dist = torch.sum((data - centroid) ** 2, -1)
        distance = torch.minimum(distance, dist)
        farthest = torch.max(distance, -1)[1]

    return index_points(data, centroids).contiguous()
二つ目に、公式実装ではエンコーダだけ fp32、LLM を bf16 にしていますが、MPS で実行したところ以下の assertion で落ちたためどちらも fp32 に統一しました。
failed assertion `Destination NDArray and Accumulator NDArray cannot have
different datatype in MPSNDArrayMatrixMultiplication'
また、使用する点群データは PointLLM と同様の形式で良いため、先ほどと同じデータを利用して実験を行なっています。
推論の実行には eval_objaverse.py を元にしたスクリプトを利用しています。
試した結果
PointLLM と同じ点群・同じプロンプトの結果を比較してみます。
| プロンプト | garden_gnome | Barrel_01(赤) | barrel_03(青) | |
|---|---|---|---|---|
| What is this? | PointLLM | small doll, green clothes and red shoes | cartoon-style red barrel | cartoon-style oil tank |
| GreenPLM | character, a man, in a vibrant red shirt | cylindrical container, red, with a black top | cylindrical container, a barrel, blue | |
| What color is this object? | PointLLM | predominantly green | The object is red. | a vibrant shade of blue. |
| GreenPLM | predominantly red | The object is red. | The object is blue. |
「庭のノーム像」の差分としてはメインの色の判断が割れています。実物の点群は赤い帽子に緑の服なので、PointLLM は服を、GreenPLM は帽子をメインの色と捉えています。
「赤い樽 vs 青い樽」では GreenPLM だけが「黒い蓋」という形状のディテールに言及しました。一方で物体名は container 止まりで、barrel と言い切った PointLLM の方が具体的でした。
また実行時の速度差は以下のようになりました。
| PointLLM (fp16) | GreenPLM (fp32) | |
|---|---|---|
| ダウンロード量 | 27.65GB | 7.3GB |
| モデルロード | 8〜20秒 | 1.4〜2.8秒 |
| 1応答 | 11〜44秒 | 0.6〜8.3秒 |
dtype で不利な条件にもかかわらず、GreenPLM が一貫して速いという結果となりました。3.8B と 7B のパラメータ差がそのまま出ています。
SAGE
手法の概要
最後は SAGE(CVPR 2026)についてご紹介します。こちらはタイトルの "Point Cloud as a Foreign Language" が、手法をそのまま言い表しています。
これまでの2手法は、事前学習済みの 3D エンコーダで幾何学的な特徴を抽出し、それを LLM に橋渡ししていました。しかし SAGE では幾何の空間と言語の空間はそもそも意味的にズレており、橋渡しには無理があるという課題に着目します。
そこで SAGE は事前学習済みエンコーダを廃し、軽量な 3D トークナイザを導入しています。点のサンプリングと近傍集約を行い、ベクトル量子化で点群を離散トークンに変換します。連続ベクトルを辞書の見出し語に丸めるイメージです。こうして得られたトークンで LLM の語彙を拡張してしまえば、点群はもはや外国語の一種として扱えます。
ベンチマーク比較
Objaverse でのキャプション生成・分類、MM-Vet での VQA(いずれも GPT-4 スコア)です。
| Model | Captioning | Cls. | VQA |
|---|---|---|---|
| SAGE-13B | 52.87 | 58.48 | 54.89 |
| SAGE-7B | 50.98 | 57.11 | 49.53 |
| ShapeLLM-13B | 48.94 | 54.00 | 53.10 |
| PointLLM-13B | 48.15 | 54.00 | 46.60 |
| PointLLM-7B | 44.85 | 53.00 | 41.20 |
全指標で高い結果を示しており、また効率面でも H100 での推論が 100ms と PointLLM の 239ms に対して 2.3 倍速く、学習時間も 18.0h 対 26.1h と短くなっています。エンコーダを外したぶん軽くなっているのが反映されていそうです。
M4 Pro で動かす (重み公開待ち)
残念ながら、現時点では学習済みの重みが公開されていないため動かすことはできませんでした。なのでこちらは手法の紹介とだけさせていただきます。
まとめ
| 手法 | 新規性の核 | M4 Pro で実行可能か | 精度 | 軽さ |
|---|---|---|---|---|
| PointLLM | 3D MLLM の最小構成 | 可 | △ | △ |
| GreenPLM | 3D データをテキストで代替 | 可 | ○ | ◎ |
| SAGE | 点群を離散トークン化し LLM の語彙へ | 不可 | ◎ | ◎ |
3手法は 「3D エンコーダをどう扱うか」という観点に差があります。事前学習済みエンコーダに頼る PointLLM、エンコーダは使いつつ学習データを削る GreenPLM、エンコーダ自体を捨てる SAGE、という違いになります。
点群を扱える 3D MLLM のモデルについては、引き続き新たなモデルが現れたらウォッチしていこうと思います。
オプティムでは AI・IoT 技術によりビジネス課題・社会的課題の解決を目指しています。今回ご紹介した 3D MLLM 技術など最新のアプローチを駆使し、点群や 3D 領域での実用的なソリューション開発に興味のあるエンジニアを募集しています。
